AlphaNIST: một policy robot duy nhất đạt 98,2% trên 20 bài lắp ráp, không cần dữ liệu trình diễn
Từ AlphaGo đến cánh tay robot
“Từ AlphaGo đến AlphaZero của Google DeepMind, chúng ta đã thấy máy móc tìm ra những nước đi vượt ngoài tưởng tượng” – nhà nghiên cứu Octi Zhang (@octi_zhang) mở đầu chuỗi bài giới thiệu AlphaNIST như vậy. Theo ông, không ai dạy cho các hệ thống đó những chiến lược ấy; chúng tự xuất hiện nhờ học tăng cường: chơi, thất bại và thử lại dưới một tín hiệu thưởng nhị phân duy nhất. Chuỗi bài có khoảng 640 lượt thích và hơn 52.000 lượt xem khi chúng tôi ghi nhận.
AlphaNIST áp dụng triết lý đó cho robot lắp ráp. Theo bản tổng hợp tin tức của X, đây là công trình của các nhà nghiên cứu tại NVIDIA và Đại học Washington.
Kết quả nổi bật
- Một policy duy nhất đạt tỷ lệ thành công 98,2% trên 20 bài lắp ráp phức tạp trong môi trường mô phỏng;
- Huấn luyện từ đầu, chỉ với phần thưởng nhị phân (thành công/thất bại) cộng chi phí điều khiển;
- Không cần dữ liệu trình diễn của con người và không tinh chỉnh riêng cho từng bài;
- Xử lý từ đai ốc lục giác M4 đến chốt 4 mm, và có thể nối liền 10 bài theo chuỗi.
Các bài kiểm tra được đặt theo bộ chuẩn lắp ráp của NIST (Viện Tiêu chuẩn và Công nghệ Quốc gia Mỹ) – vốn được dùng để đo năng lực thao tác chính xác của robot công nghiệp.
“Kết quả ấn tượng nhất trong thời gian làm tiến sĩ của tôi”
Patrick Yin (@patrickhyin), một cộng sự trong dự án, viết: “This is the most impressive result I’ve seen in my PhD.” Ông nhấn mạnh rằng một policy huấn luyện từ đầu đã giải cả 20 bài lắp ráp NIST, và có thể hoàn thành 10 bài liên tiếp dù chỉ nhận một tín hiệu thưởng duy nhất sau khi cả 10 bài xong.
Theo X News, các cộng sự cũng cho biết AlphaNIST vượt trội so với việc dùng 20 policy chuyên biệt riêng lẻ, trong khi tốn ít tài nguyên tính toán hơn.
Những “nước đi” con người không nghĩ tới
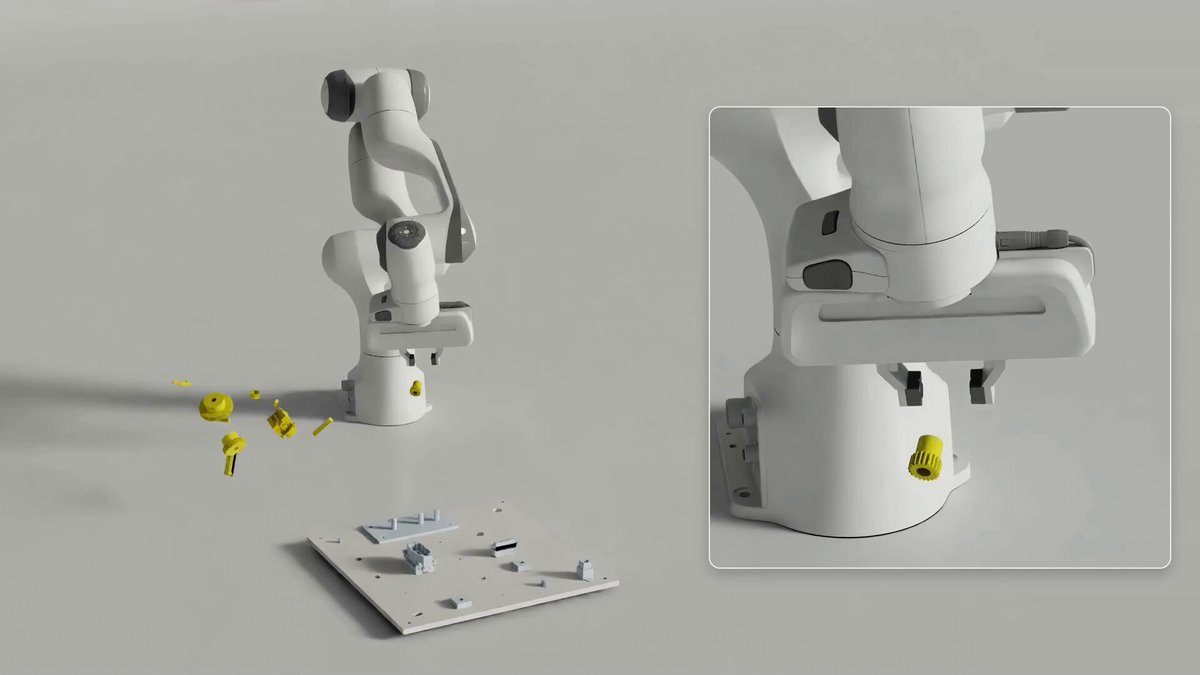
Giống AlphaGo từng gây bất ngờ với những nước cờ lạ, Octi Zhang cho biết robot đã tự tìm ra những cách làm khiến nhóm ngạc nhiên, như kiểu cầm nắm thông minh hơn hay tận dụng chính tấm bảng lắp ráp để xoay lại chi tiết. Video trên trang dự án cho thấy cánh tay robot màu trắng thao tác chính xác với các linh kiện nhỏ màu vàng và xám.
Còn khoảng cách với nhà máy thật
Cần lưu ý: tỷ lệ 98,2% đạt được trong mô phỏng. Đưa policy từ mô phỏng ra robot thật luôn là thách thức lớn do khác biệt về ma sát, sai số cảm biến và độ trễ. Dù vậy, việc một policy duy nhất học được nhiều kỹ năng lắp ráp mà không cần người trình diễn là tín hiệu tích cực cho tự động hóa sản xuất, nơi chi phí thu thập dữ liệu trình diễn thường rất cao.
Nguồn tham khảo
- @octi_zhang – giới thiệu AlphaNIST
- @patrickhyin – “most impressive result I’ve seen in my PhD”
- X News – AlphaNIST Robot Masters 20 Assembly Tasks with Single Policy
Số liệu tương tác (lượt thích, lượt xem) được ghi nhận khoảng 7h30 ngày 14/10/2026 (giờ Việt Nam) và có thể đã thay đổi. Một phần nội dung tổng hợp từ X News – bản tóm tắt bài đăng trên X có thể tiếp tục được cập nhật.
Tác giả: Ban biên tập
Ý kiến bạn đọc
Những tin mới hơn
Những tin cũ hơn